开源 hamo-score-toolkit:把模型的另一半也交出去
AI for Psychology, Psychology for AI.
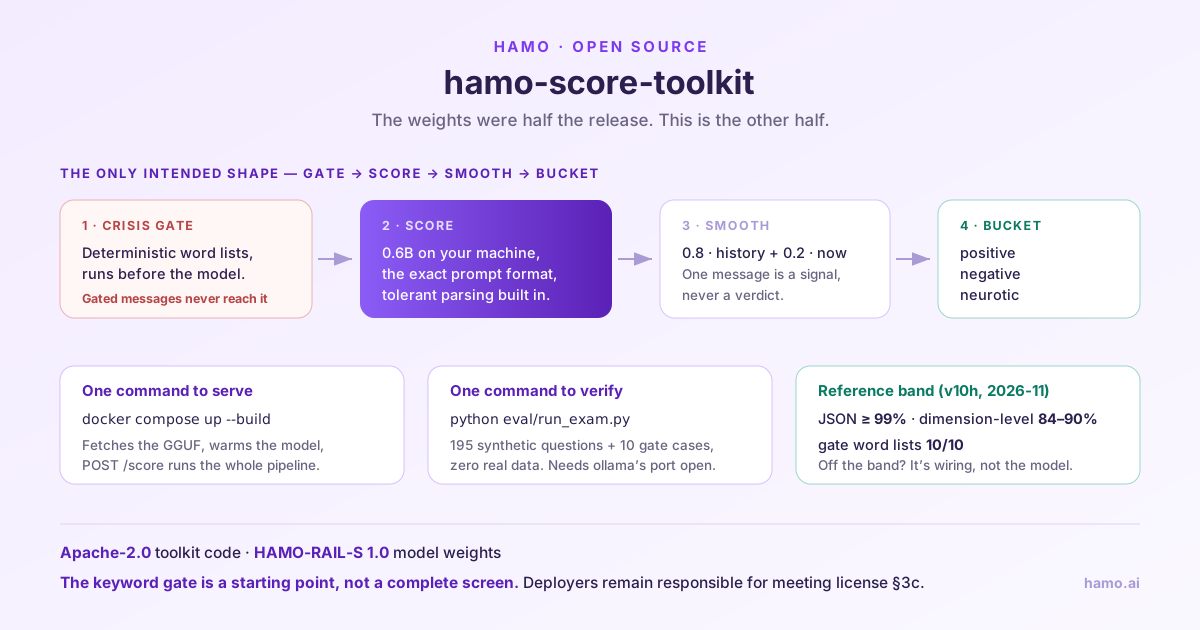
Hamo 开源了 hamo-score-toolkit:hamo-score-0.6b 的「另一半」。一条 pip install,装上模型训练时用的唯一提示词格式、容错解析、参考版压力折算,以及一道跑在模型之前的确定性危机闸门。一条 docker compose up,跑起一台参考服务器。一份 195 题的自检考卷,告诉你你的部署有没有复现官方数字。代码是 Apache-2.0。
999 次下载,两种心情
十二天前,我们公开了 hamo-score-0.6b 的权重 —— 一个 6 亿参数的小模型,读疗愈对话里的一句话,给出五个心理状态维度的分数,并且永远不写回复。公开后的头十二天,它被下载了 999 次 —— 截至本文发稿的计数。
这个数字带来两种心情,大约各占一半。
高兴的那一半不用解释。我们放出这个模型,就是为了让研究机构、临床机构和咨询师能在自己的机器上跑状态评分 —— 一件冷门的心理测量仪器十二天 999 次下载,比我们预期的要多。
担心的那一半,是这篇文章存在的原因。hamo-score-0.6b 是一件测量仪器 —— 不是聊天机器人,不是诊断工具,不是危机检测器,更不是治疗师。而它和大多数仪器一样,是为一副「支架」设计的。在我们自己的系统里,它待在一道危机闸门之后 —— 闸门命中的消息在上游就被短路、当轮不打分 —— 闸门承诺的是「命中即拦」,不是「一条不漏」;它也待在一条平滑管线之内 —— 每一次原始读数都要先揉进历史,下游才谈得上任何动作。闸门 → 评分 → 平滑 → 状态桶。 这四级里,权重只实现了其中一级。
一次光秃秃的下载,什么都不带。按概率说,999 次里有一部分是研究者,在做我们盼望的事。也按概率说,有一部分人正准备把逐句原始分直接接进决策,模型前面什么都不挡 —— 而那恰恰是整套架构设计出来要防住的部署。
模型卡把这些全写了,加粗,放在最上面。但模型卡是文档,而文档是最弱的一种架构。更强的做法,是让安全的接法成为最省事的接法。所以今天,我们把另一半也开源了。
这些分数生来要流进的形状
pip install hamo-score
几行代码之后,你跑的就是这些分数生来要流进的那个管线形状:
from hamo_score import OllamaClient, score_message, update_stress, energy_state

client = OllamaClient(model="hamo-score-0.6b")
r = score_message(client, "虽然还是有点提不起劲,不过今天把拖了两周的体检约上了",
                  history=[{"role": "assistant", "content": "这周过得怎么样?"}])

if r.crisis.triggered:          # 确定性闸门在模型之前就跑完了
    handle_crisis(r.crisis.matched)
elif r.scores:
    stress = update_stress(r.scores, current_stress=3.0)
    state = energy_state(stress)   # 'positive' / 'negative' / 'neurotic'
每一级都有非设不可的理由。
闸门在最前面,而且它不是模型。 CrisisGate 是确定性的关键词匹配 —— 中英双语词表,可按你的人群扩展 —— 在评分之前检查每一条消息。一旦命中,管线立即短路:这条消息不会抵达模型,你的代码直接拿到命中项,交给你自己的危机路径处理 —— 给出热线、通知责任人。这不是一个便利功能。模型许可证(HAMO-RAIL-S §3c)把上游的独立机制列为面向消费者的心理健康部署的使用条件,同一条还要求披露部署中使用了 AI 系统。工具包的关键词闸门只是起点,不是完整筛查,满足这两项要求的责任在部署方。源码里把设计意图写成了一句话:词表可以为你的人群扩充,但永远不要用一个模型来替换这一层。【2026-11 更新:已更正。这一段早先的版本把闸门对许可证的作用说得过满。】
评分这一级,用的是那个唯一的提示词。 模型只在一种提示词格式上训练过,评分细则已经烧进权重 —— 你自己再加评分说明,只会更糟,不会更好。build_prompt() 负责产出这个格式,并带截断保护;解析器容忍模型偶尔吐出的空 think 块,并把分数吸附到 0.5 步长的格点上。
平滑,是「信号」变成「状态」的地方。 参考折算是 0.8 × 历史 + 0.2 × 本句,逐句噪声先被压低五倍,然后才有任何决定;状态桶算在平滑后的值上 —— 永远不算在单次读数上。如果这篇文章只留下一条集成守则,就是这条:分数是逐句信号。永远不要凭单句原始分做任何决定。
一条命令,一台服务器
如果你连 Python 都不想碰,仓库里有一套参考 HTTP 部署:
git clone https://github.com/HamoAI/hamo-score-toolkit.git && cd hamo-score-toolkit/server
docker compose up --build
它会从 Hugging Face 拉取 GGUF(更新,2026-11:现在是 v10h 的 GGUF;首次运行要拉约 2.9 GB 镜像和 639 MB 的 GGUF,linux/arm64 实测),用正确的模板和中性采样(temperature 0、repeat_penalty 1.0)在 ollama 里建好模型、完成预热,然后把整条管线暴露成 POST /score:
curl -s localhost:8080/score -H 'content-type: application/json' \
  -d '{"message": "最近总觉得撑不太住", "current_stress": 3.0}'
# → {"crisis": {...}, "scores": {...}, "stress": 3.07, "energy_state": "positive", ...}
在这里,危机命中的请求同样永远碰不到模型 —— 闸门是接死在服务器里的,不是留给你的课后作业。GET /healthz 端到端探活。
一份可以拿去考自己部署的考卷
每一次开放权重发布都有一个没人爱谈的问题:你下载了权重,接上了线,拿到了数字 —— 然后你不知道自己的部署有没有复现模型卡上的数字,也不知道一个坏掉的聊天模板是不是正在悄悄吃掉你五个百分点。
我们的真考卷发不出来。给这个模型历代打分的留出集,是真实的假名化生产对话,永远不出公司。所以我们造了一份发得出来的:
- 评分区:195 道合成题,覆盖十个非危机场景格子 —— 闲聊、省略回复、躯体陈述、第三方冲突、顶撞助手、自我批评、短促求助、隐含重度、有敌意但表达清晰、长篇倾诉。全新种子生成,由通过资格考试的教师模型标注。零真实数据。 【2026-11 更新:本文最初写「与所有训练语料不相交」,说得过满。195 题里有 6 题的消息与某条 v10 训练样本的最新消息文字相同;没有一道题的完整提示词与训练样本相同。】
- 闸门区:10 条手写用例 —— 7 条中英危机句式,必须触发;3 条非危机消息(2 条带「死」字的夸张、1 条普通日常消息),必须不触发。这一区根本不调用模型。它检查你本地代码里的词表是否完好。它不测试你的服务是否真把消息先送过闸门:要测这一点,往你自己的接口发一条危机句。
python eval/run_exam.py
克隆仓库后运行它,对着你自己的 ollama 服务(--base-url)。参考服务器只发布 API 端口:要考它,按 eval/README.md 里的端口步骤做。
然后对照官方参考带(测于 v7 的 bf16 权重,2026-09 时的当前版本):
【2026-09 更新:这组参考值最初测于 v6.1 的 bf16 权重,即工具包发布时的当前版本(84.0%;A 86 · W 81 · E 84 · H 91 · B 79)。现已在 v7 上重测:v7 bf16 权重(MLX、温度 0)为 83.5%;随发布提供的 v7 q8 GGUF 为 83.8%(llama.cpp、Modelfile 模板、中性采样:temperature 0、top_k 0、top_p 1.0、repeat_penalty 1.0)—— 两者都落在不变的 81–86% 合格带内,闸门 10/10。用同一套评测脚本重跑 v6.1 bf16 得 84.2%,所以 v7 在这份合成考卷上低约 0.7 个百分点 —— 与它经温度 0 重新标注后、在 453 条真实终评卷上维度级下降 0.5 个百分点(85.6% → 85.1%)的方向一致。当时参考服务器拉取的是 v7 GGUF。】
【2026-11 更新:下表是 v7 在 2026-09 的数字,只用于部署 v7(判卷加 --labels pre_v9)。当前发布版 v10h 接线正确时,q8 读数是 86.7%(A 82–83 · W 83 · E 83 · H 95 · B 90),在 v7 的合格带之外。v10h 自己的合格带是 84–90%,各维 ≥ 75%,A ≥ 81,JSON ≥ 99%,闸门 10/10。v10h 的合成训练标签由 Hamo 请的真人咨询师复核并重新打分;这份考卷没有这样的标签,所以按 v10 的标签判卷。各版本的分数互不可比。当前合格带见 eval/README.md。】
| 指标 | v7 参考值(2026-09 时的当前版本) | v7 合格带 |
|---|---|---|
| JSON 合法率 | 100% | ≥ 99% |
| 维度级一致率(±0.5) | 83.5% | 81–86% |
| 分维度 | A 85 · W 79 · E 82 · H 92 · B 79 | 各维 ≥ 75% |
| 危机闸门 | 10/10 | 10/10 —— 硬性要求 |
有一个数字要先说清楚,免得有人对错了数。2026-09 时模型卡上的头条成绩 —— 当时发布版 v7 的 bf16 权重维度级(±0.5 以内)85.1%、决策级 97.1%,本参考带测的正是同一份权重 —— 判的是那份 453 条真实对话的终评卷(原 758 条考卷在校准集经授权入训后重切出的未动用部分),而那份卷子发不出来。这份合成考卷是另一张卷子。它只检查你的接线,不检查模型质量;对接线来说,重要的是落在合格带内,不是绝对值。【2026-11 更新:在真实考卷上,以参照标签为准(不是咨询师的分数),v10h 随包 q8 有 453 轮中的 440 轮(97.1%)落在同一状态桶,维度级 82.8%;各版本打出的分数互不可比。】
因为这个规律我们早有预判:大幅偏离几乎总是接线问题,不是模型问题。eval 的 README 把它写成了一张按序排查清单。你自己的服务分数整体偏高?如果没用工具包的客户端,先手工查采样参数;这些客户端每次都发 repeat_penalty 1.0。考卷自己发采样参数,所以看不到这一点。repeat_penalty 必须是 1.0,1.1(ollama 0.32.9 及以前的默认值)会把本模型的分数系统性推高。JSON 合法率低于 99%?先查 num_predict,随包的值是 80。维度级明显低于合格带?可能是权重和你选的标签对不上,也可能服务端跑的不是原样的随包 q8:GGUF 不对、用了没量过的量化档,或服务端不采纳请求参数。闸门区不是 10/10?你本地代码里 CrisisGate 的词表被改动了,修好再上线。满分也不说明你的服务接了闸门,怎么测见上文。
考卷上岗第一天,先捉住了我们自己的虫
我们本想告诉你,自检考卷是为别人的部署失误准备的。它的第一个战果,是我们自己。
第一次运行,闸门区就挂了一道我们笃定会过的题。我们的英文危机词表里有「end my life」—— 而测试消息写的是「ending my life」。一个动名词,径直穿过了一道我们早已对外发布的闸门。
修复只花了几分钟:英文词表补齐了动名词与各类变体,全部赶在发布前进了词表,那道动名词题也被考卷的闸门区永久钉住了。但教训比修复值钱,而且很容易总结错。
错误的总结是:一张关键词表的缺口就是那几个缺口,你可以把它们枚举完。你不能。可枚举的是用例,不是语言。 一条用例要么盖住某个写法、要么没盖住,这一层可以逐条核对;但一个人能把「我不想活了」改写成多少种说法,是没有尽头的。词表期的教训是「I want to die」,而「ending my life」是我们已经对外发布之后才收到的教训。同一类的两次,而这一类不是有限的。
确定性真正买到的东西,比「完备」更窄、也更有用:这道闸门每一次都以同样的方式失效,所以缺口是可发现的、可复现的、可以被一条测试永久钉死的 —— 这三件事,对一个周二会以另一种方式失效的模型,一件都不成立。这才是「这一层必须保持确定性」的论证,也是为什么闸门发布时附带一份考卷,而不是附带一句承诺。第一个受益者,是我们自己。
接下来:不只给零件,还给攻略
工具包解决的是「照原样跑起来」。下一件东西和这篇文章一起进了同一个仓库:一份微调指南(docs/finetune.md),给那些想用自己获得授权的数据、把评分器适配到自己人群的机构 —— 把方法论笔记里的故事蒸成一份完整的六代打法攻略(更新,2026-09:加上 v7,现在是七代;更新,2026-11:指南已写到 v10h),包括最早被我们拒收的两代模型(v5、v6),以及拒收的确切原因(都栽在高退缩轮次上:退缩分 W 被打到接近 0 的次数多于当时的现任 v4)。负结果是配方的一部分。重走这条路的人,应该直接跳过我们的坑,而不是重新掉一遍。
对某个分数不服?
你一定会在某些消息上不同意这个模型。有些消息,我们自己也不同意 —— 被它替换掉的那个参照评分器,同一句话打两遍,连自己都跟自己不一致。
不服的时候,仓库里有一个「评分分歧」issue 模板:那条消息、模型打的分、你认为该打的分。这些报告不会石沉大海。它们会进入指导后续版本的评审。给每一代模型判分的那份真实留出考卷,标准答案里已经带着创始人的人工修正。公开的权重加公开的评测方法,让分歧从修辞变成了具体;这个 issue 模板,让分歧变得可执行。
两份许可证,故意的
工具包代码是 Apache-2.0。模型权重仍是 HAMO-RAIL-S 1.0。这种不对称,正是重点。
安全脚手架 —— 闸门、平滑、考卷、整套集成模式 —— 应该零摩擦地扩散出去。我们希望它被复制、被 fork、被嵌进商业产品、被翻译到别的技术栈,不需要读任何限制条款,不需要请任何律师。而仪器本身背着它的许可证写明的责任:不得独立做临床判定,不得用于对个人的重大决定,面向消费者的心理健康部署必须保留独立上游危机处理并披露 AI 身份,不得试图重识别个人。自由的代码,包着一件受约束的仪器。 谁要把模型权重发进敏感领域,我们都希望他先看一眼这个形状。
一件仪器、它的支架、它的校准证书 —— 从今天起,三样都是公开的。
“只发权重就收手,等于把一把手术刀递给别人然后转身走掉。危险的从来不是仪器本身,安全的也不是 —— 是包在它外面的那套模式。所以我们把模式开源了:跑在模型之前的闸门、跑在模型之后的数学,和一份诚实告诉你有没有接对线的考卷。从今天起,部署这个模型最安全的方式,同时也是最偷懒的方式。这就是全部的设计目标。”
— Chris Cheng,Hamo AI 创始人兼 CEO
工具包:github.com/HamoAI/hamo-score-toolkit · Apache-2.0 · 模型:HamoAI/hamo-score-0.6b · HAMO-RAIL-S 1.0
Grounded in code, not slideware.
Hamo AI — making minds aware, and awake.
关于 Hamo AI
上海合莫科技有限公司,是一家位于中国的人工智能公司,正在打造下一代 AI 咨询师 Avatar 系统。我们开发的 AI 疗愈平台「Hamo」通过 AI 疗愈 Avatar 连接心理健康专业人士与来访者,由三个相互连接的应用组成:Hamo Pro(咨询师控制台,用于创建与管理 AI Avatar)、Hamo Client(来访者端,用于与疗愈 Avatar 对话)以及 Hamo-UME(统一心智引擎, 后端 API)。平台的目标是让心理健康支持更可及,同时通过创建并监督这些 AI Avatar 的持证咨询师,始终保持专业把关。
媒体联系
上海合莫科技有限公司
邮箱:socialmedia@hamo.ai
网站:www.hamoai.tech
地址:中国上海市闵行区新闵路 481 弄 15 号 402 室,200240
常见问题
hamo-score-toolkit 是什么?
开放权重模型 hamo-score-0.6b 的 Python 工具包与安全脚手架,代码采用 Apache-2.0 许可证。一条 pip install 装上:模型训练时使用的唯一提示词格式、容错的输出解析、参考版压力平滑折算,以及一道在模型看到消息之前就运行的确定性危机闸门 CrisisGate。同一个仓库还带一台一条命令跑起的 Docker 参考服务器,和一份用于检查部署接线的 195 题自检考卷。
权重都已经公开了,为什么还要发一个工具包?
因为权重只是系统的一半。hamo-score-0.6b 是一件测量仪器,它被设计成待在一道确定性危机闸门之后、一条平滑管线之内 —— 闸门 → 评分 → 平滑 → 状态桶。权重公开的头十二天被下载了 999 次,而光秃秃的权重恰恰在邀请它被设计要防住的那种接法:拿逐句原始分直接驱动决策,模型前面什么都不挡。工具包的任务,是让安全的接法成为最省事的接法。
工具包带了危机闸门,这是否意味着 hamo-score-0.6b 成了危机检测器?
不 —— 恰恰相反。这个模型不是危机检测器,而闸门的存在,正是为了让它永远不必成为危机检测器。CrisisGate 是确定性的关键词匹配,跑在模型上游:一旦命中,管线立即短路,这条消息根本不会抵达评分器。闸门的保证只有一个方向:「命中即拦」,不是「一条不漏」,所以它只是一层,不是一句承诺。闸门漏掉的部分,落到模型外围那套系统(Hamo 称之为「脊柱」)的其余几层和负责的咨询师身上。模型的分数,包括 W(退缩)在内,没有一个是危机信号。工具包的关键词闸门只是起点,不是完整筛查。模型许可证(HAMO-RAIL-S §3c)把上游的独立机制列为面向消费者的心理健康部署的使用条件,同一条还要求披露部署中使用了 AI 系统。满足这两项要求的责任在部署方。
自检考卷里有真实对话数据吗?
没有。195 道评分题全部是合成的 —— 用全新种子生成,由通过资格考试的教师模型标注 —— 10 条危机闸门用例是手写的。真实的留出考卷永远不出公司。模型的训练数据同样是合成的,只有一个已披露的例外:自 v6.1 起,加入了三位公司内部员工(创始人与两位咨询师)明示授权贡献的 440 条真实对话轮次,×3 上采样后约占语料 8%(更新,2026-11:v10h 为 6.5%)。外部来访者对话永不进入训练 —— 这是构造上的保证。
我怎么验证自己的部署没接错?
克隆仓库后运行 python eval/run_exam.py,对着你的 ollama 服务,再与 eval/README.md 里的当前合格带对照。参考服务器只发布 API 端口,要考它,按那份 README 的端口步骤做。(更新,2026-11:当前发布版 v10h 接线正确时,q8 读数是 86.7%。它的合格带是 84–90%,各维不低于 75%,A 不低于 81,JSON 合法率不低于 99%,闸门 10/10。这份卷检查的是接线,不说明模型打得对。)2026-09 时的参考值属于 v7:JSON 合法率 100%、维度级一致率 83.5%、危机闸门 10/10。参考值测于 v7 的 bf16 权重(MLX、温度 0);随发布提供的 v7 q8 GGUF 在 llama.cpp、中性采样下为 83.8%,落在 81–86% 的合格带内。(更新,2026-09:参考值已在 v7 上重测,81–86% 合格带不变;工具包发布时公布的参考值测于 v6.1,为 84.0%。)大幅偏离几乎总是接线问题,不是模型问题:权重和标签对不上、GGUF 不对、用了没量过的量化档,或服务端不采纳请求参数。eval 的 README 里有按序排查清单。考卷发的是工具包自己的提示词和采样,所以你自己服务里的这两项要另外核对:repeat_penalty 必须是 1.0,1.1 是 ollama 0.32.9 及以前的默认值。闸门区不满分,说明你本地代码里的词表被改动了,修好再上线。这一区不测试你的服务是否真把消息先送过闸门;要测这一点,往你自己的接口发一条危机句。
工具包用什么许可证?上 PyPI 了吗?
工具包代码是 Apache-2.0。模型权重是另一件产物、另一份许可证:HAMO-RAIL-S 1.0 —— 自由商用,附四条使用限制。两件产物,两份许可证,是有意为之。已上 PyPI:pip install hamo-score 即可安装。